本帖最后由 anyangmo 于 2026-5-22 10:18 编辑
智谱 GLM-5.1 高速版 AI 模型发布,跑出全球最快速度 400 tokens/s
IT之家 5 月 22 日消息,智谱今日宣布面向部分企业客户提供 GLM-5.1 高速版 API“GLM-5.1-highspeed”。
该模型输出速度达到 400 tokens/s,刷新当前全球大模型厂商 API 的速度上限。
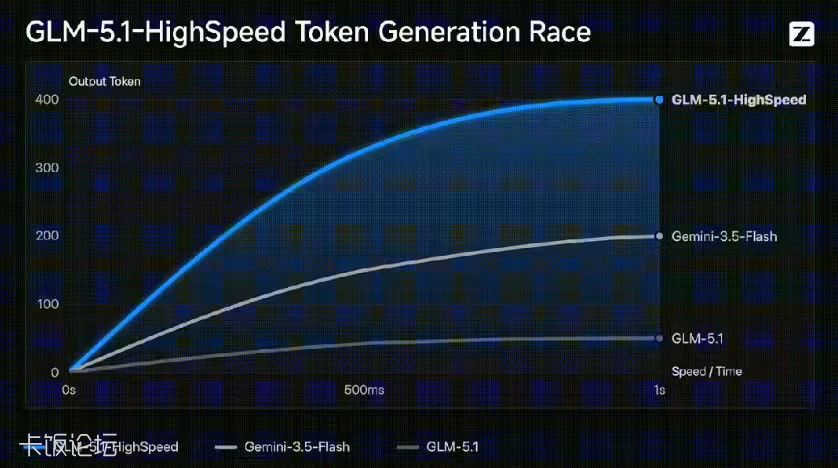
更重要的是,在过去,“快”往往意味着“小”,高速模型几乎总是轻量级模型。GLM-5.1 高速版打破了这一行业惯例,首次在国产大模型中,将旗舰级能力与低延迟同时带入生产环境。
GLM-5.1 高速版 API“GLM-5.1-highspeed”由智谱 GLM 团队与 TileRT 团队联合打造,在推理引擎、调度系统与底层基础设施三个层面进行了系统级优化:
- 推理引擎层:针对 GLM-5.1 的架构特点,重写了核心推理路径,提升了单卡吞吐能力;
- 调度系统层:通过动态批处理、请求合并和 KV 缓存调度优化,降低高并发场景下的尾延迟;
- 基础设施层:围绕推理集群部署、网络链路、负载均衡进行协同优化,确保 400 TPS 不是一个“峰值”数字,而是稳定可用的生产级能力。
模型推理速度的理论上限由硬件决定,但真实系统通常距离物理极限仍存在巨大差距。核心问题在于推理框架的调度方式。当前主流框架仍以 operator / kernel 作为基本调度单元,每个算子都要经历“host 启动 → 读权重 → 计算 → 写回 → 同步”的严格完整链路。当推理进入单 token、小 batch、多卡 TP 的场景后,算子被切到微秒级,原本可忽略的调度、访存与同步开销会被迅速放大。
TileRT 的设计思路,是彻底抛弃 Runtime 层的动态调度,在编译期(AOT)将整个计算图静态编排为一个常驻 GPU 的 persistent Engine Kernel。
- 在单卡之内,计算、异步 IO 与通信被全部拆解为 Tile 级微任务,整个推理过程只 Launch 一次 Engine Kernel,算子间的中间结果不再写回 Global Memory,而是经由 Register、Shared Memory 与 L2 Cache 直传,host 调度与跨算子同步被悉数压进同一个常驻 kernel。
- 在多卡尺度上,TileRT 进一步将 SM 内部的 Warp Specialization 思路外推到整张 8 卡 NVL 拓扑。不同 GPU rank 不再执行同构逻辑,而是按计算密度与数据依赖被特化为不同 worker。
GLM-5.1 高速版适用于 AI 编程、实时交互、商业决策、实时语音等对响应延迟要求高的场景,现已面向智谱 MaaS 平台部分企业客户开放服务。
IT之家附模型链接如下: https://docs.bigmodel.cn/cn/guide/models/text/glm-5.1-highspeed
原文地址:https://www.ithome.com/0/953/717.htm
| 



 发表于 2026-5-22 10:17:27