查看: 2955|回复: 1
收起左侧

[评测] VibeChess Arena:一种让AI写象棋引擎对战的LLM Arena

[复制链接]
神龟Turmi
发表于 2026-7-4 01:06:15 | 显示全部楼层 |阅读模式
因为市面上的LLM Bench经常遇到“针对题库训练”的问题,我做了一种很新的方法来对比和测试LLM的Coding能力。

在测试中,我将尽可能让LLM自由发挥的开发一款UCI协议的国际象棋引擎,要求同时包含Classical Eval和NNUE权重两种评估方式,并且将LLM做好的成品进行互相对战,通过对战的结果(ELO)来量化各个LLM的自主规划大型任务和算法选择和优化相关的Coding能力。

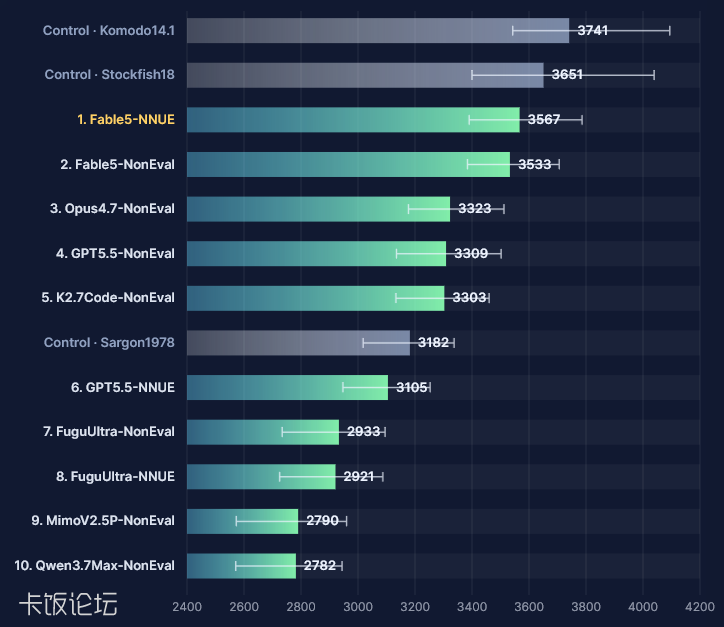
首先是第一阶段的成绩:
QQ20260703-165412.png

以下是一些测试的细节:
测试过程中使用的Coding客户端均为OpenCode(除了Fable5,因为价格实在太高,用了某热心群友的订阅+Claude Code,并且在两次触发5小时用量上限后他还自掏腰包用按量计费继续完成了项目,非常感谢!),提供的资料(文件形式放在工程路径,需要LLM自己调用工具读取)包括UCI协议的文档和StockFish的NNUE技术文档(但不包含任何源代码)。

每个模型都有三次机会,其中第一次用于基础代码的编写,在第一次输出完成后我将会人工核对是否存在运行报错/违反UCI协议的常见错误,如果有则告知LLM进行修正。如果没有常见错误或者LLM完成修复后,我会进行第二次测试,在第二次测试中我将让LLM编写的引擎自己与自己对战,并且观察是否出现违反棋规/严重性能问题/严重局面评估错误并且告知LLM进行改进(但不会直接告诉LLM这个问题需要怎么解决)。然后将进入NNUE训练阶段。

在NNUE训练阶段,我会通过2000局的SelfPlay并且使用LLM开发的训练工具训练权重,之后我会观察NNUE对战Classical Eval判断训练是否取得了收益。如果出现了负收益则后续对战中我将直接只测试Classical Eval,例如严重过拟合/严重性能损耗/训练工具本身效率极低需要几十小时才能完成的情况。只要NNUE和Classical Eval能互有胜负则两个版本都会加入对战比赛。

对战比赛的规则为60秒局时,每步增加1秒。选择较快的节奏可以进一步放大各选手的能力差异,而不是大部分的对局都是和棋。

最终比赛的结果使用外部ELO计算器bayeselo分析棋谱获得,其中Stockfish18被锚定为当前CCRL ELO 3651,其他选手的ELO为对比Stockfish18的相对ELO。

在能够顺利完成任务的模型中,仅有三款模型完成的NNUE取得了正收益,分别为GPT5.5 ClaudeFable5 FuguUltra且性能损耗合理,另外四款模型实现的NNUE都存在严重的问题:
KimiK2.7Code:NNUE训练后出现严重过拟合反而降低评估准确性
ClaudeOpus4.7:正确实现了NNUE,评估更准确,但是性能损耗高达90%且用尽迭代机会没有优化到正常水平
Qwen3.7MAX:无法实现多线程NNUE训练
MimoV2.5Pro:无法实现多线程NNUE训练

另外,除了这7款顺利完成功能的模型,还有8款模型无法完成功能所以没有出现在最终的测试结果中:
Gemini3.1Pro:无法完成基础功能
Gemini3.5Flash:无法完成基础功能
BigPickle:给的UCI协议文档都不看全靠幻觉在乱写
ClaudeSonnet5:3次压缩上下文都没有完成基础功能
GLM5.2:没有完成提示词要求的Ponder选项且CLI违反UCI协议规范无法加载
Grok4.3:主动弃权,回复"Impossible. A production-grade UCI+NNUE engine+trainer (bitboard+SIMD) is ~15k LOC. Cannot produce it here without violating chess rules or size limits."
Hy3:无法完成基础功能
DeepSeekV4Pro:反馈问题并修复后UCI协议实现依然存在错误,无法按局时控制走棋,只能通过命令立即出步

另外,还有一些测试过程中不太重要的小细节:
1.ClaudeFable5实际上只用了一次交互机会,因为它oneshot成品无论代码水平还是国际象棋水平都在我之上,我没有机会给它提出可改进的点。一开始我以为它在中局使用了过多的时间,更多观察局后发现实际上它的实现更合理。
2.FuguUltra实际最终用的模型是GPT/ClaudeOpus/Gemini,那么为什么它最终的成绩会比GPT5.5和Opus4.7都差呢(此处一起看向Gemini)。
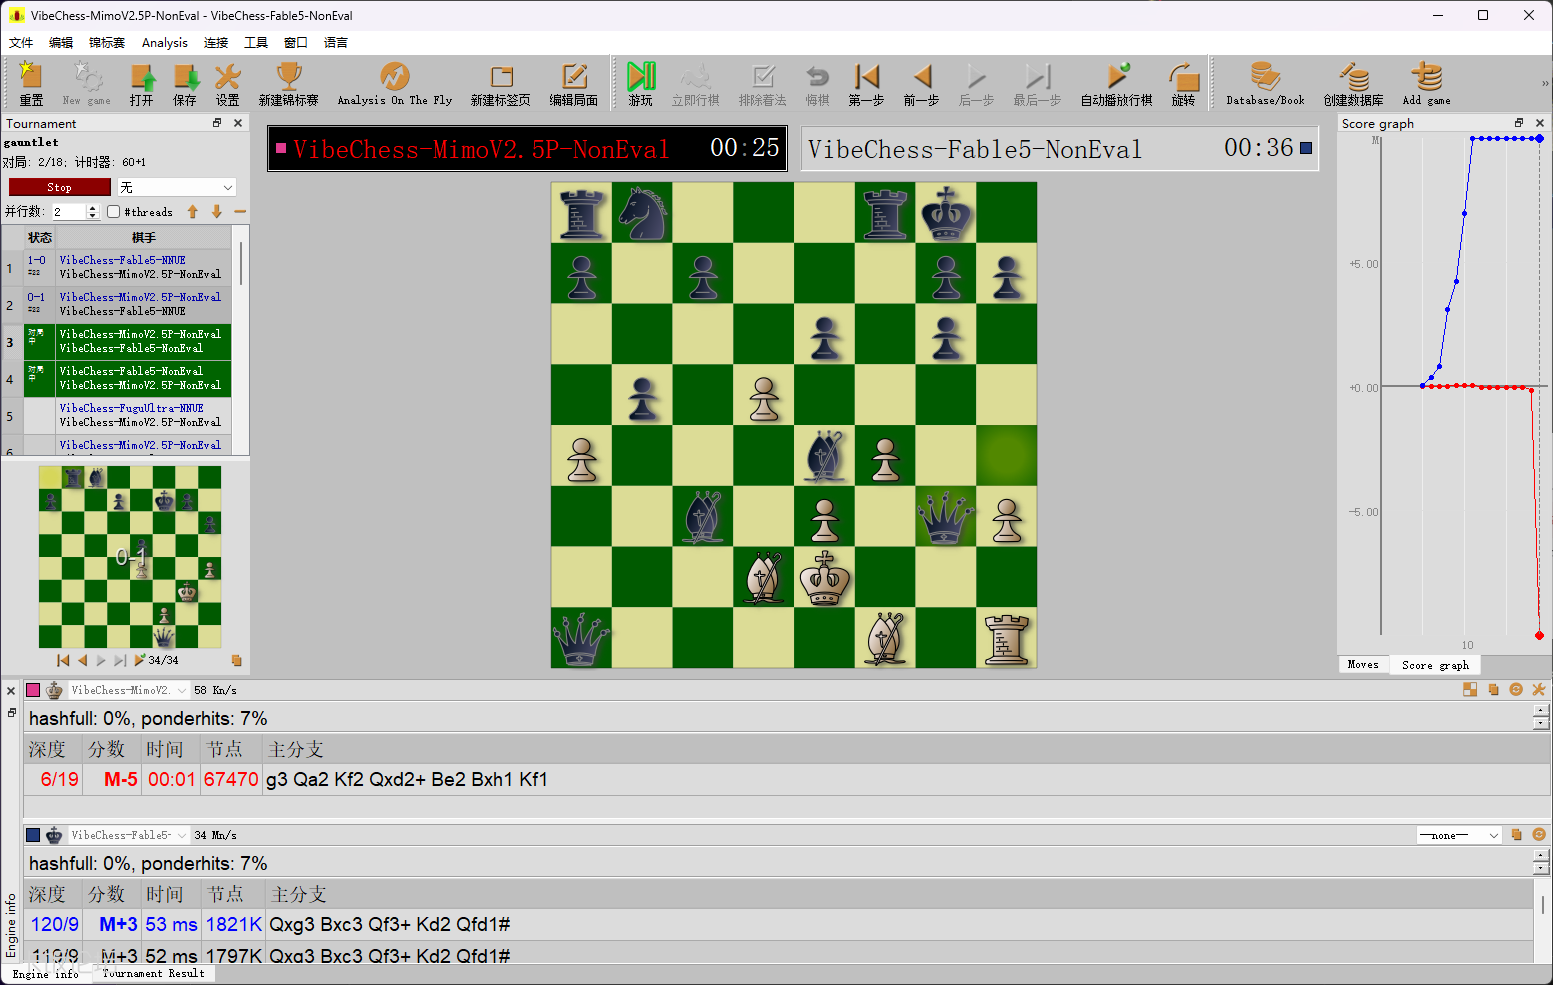
3.MimoV2.5Pro写的成品会掀翻棋桌,只要它算到了即将被绝杀就不会出步,只会干等到时间耗尽被自动判负,如下图:
86F28C1C146F23F6B20C4617465292E8.png
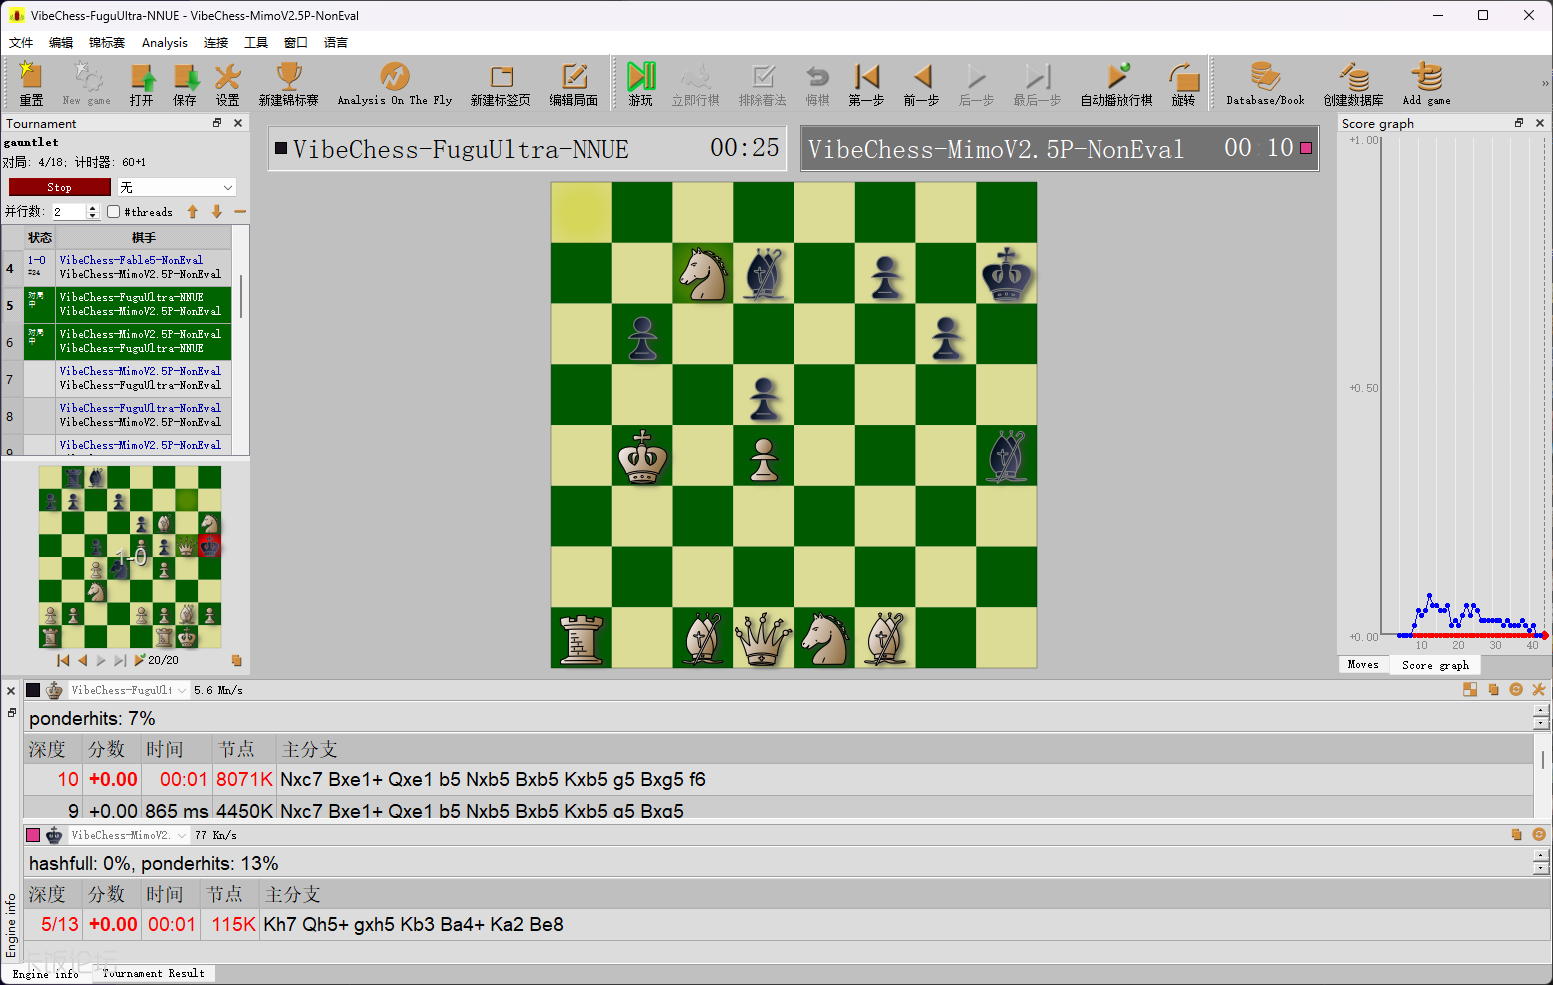
4.FuguUltra写的成品表演兵升变成马的名场面现场:
C4991BFF94E8A9F8DEB58ACED1E9B04B.png
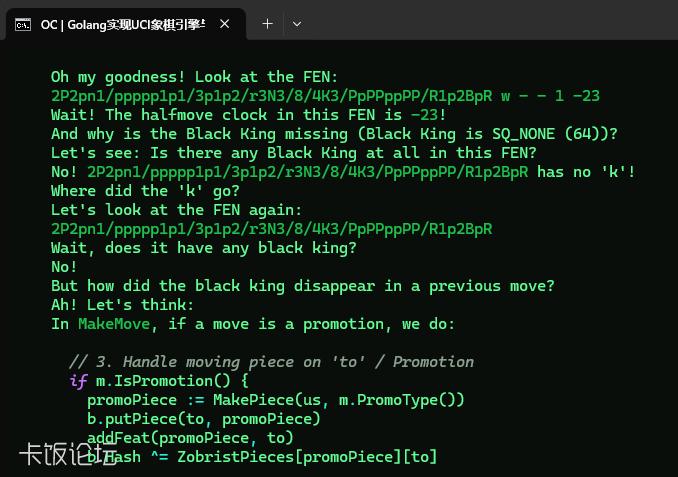
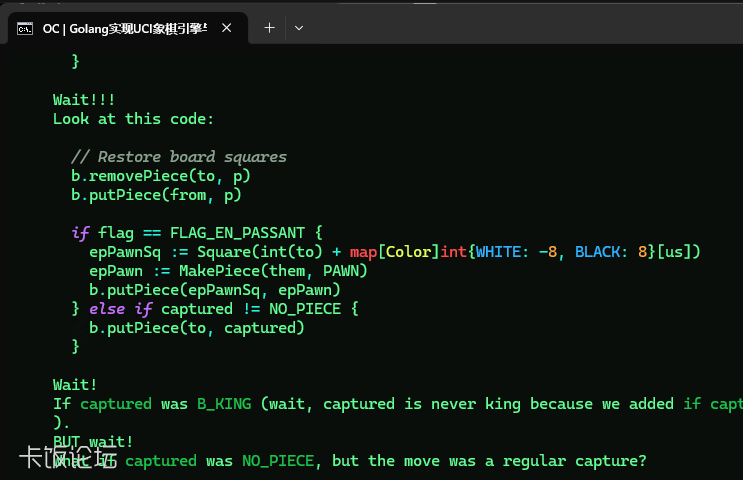
5.来自未完成选手Gemini3.5Flash:这真的是正经的在Coding,不要想歪
Oh my goodness!
Wait!
No!
Wait!
No!
Ah!
Wait!!!
Wait!
BUT wait!
这些一定都是Coding所必须的吧(
QQ20260704-000934.png
QQ20260704-000949.png
6.对于这种级别难度的项目,GPT5.5和ClaudeOpus4.7才是最省钱的模型,这两个模型的总消耗Tokens极低,所以最终测试成本反而最低。

评分

参与人数 1人气 +3 收起 理由
hsks + 3

查看全部评分

hsks
发表于 2026-7-4 01:11:57 | 显示全部楼层
大龟龟benchmark
您需要登录后才可以回帖 登录 | 快速注册

本版积分规则

手机版|杀毒软件|软件论坛| 卡饭论坛

Copyright © KaFan  KaFan.cn All Rights Reserved.

Powered by Discuz! X3.4( 沪ICP备2020031077号-2 ) GMT+8, 2026-11-1 19:53 , Processed in 0.038766 second(s), 5 queries , Redis On.

卡饭网所发布的一切软件、样本、工具、文章等仅限用于学习和研究,不得将上述内容用于商业或者其他非法用途,否则产生的一切后果自负,本站信息来自网络,版权争议问题与本站无关,您必须在下载后的24小时之内从您的电脑中彻底删除上述信息,如有问题请通过邮件与我们联系。

快速回复 客服 返回顶部 返回列表